Inference
How inference works
Juliaコンパイラーにおける「型推論」とは、入力値の型から後続の値の型を推定する処理を指します。Juliaの推論方式については、以下のブログ記事で解説されています。
- Shows a simplified implementation of the data-flow analysis algorithm, that Julia's type inference routine is based on.
- Gives a high level view of inference with a focus on its inter-procedural convergence guarantee.
- Explains a refinement on the algorithm introduced in 2.
Debugging compiler.jl
Juliaを起動して、compiler/*.jlを編集し(たとえば、print文を挿入するなど)、実行中のセッションでCore.Compilerを置き換えるには、baseに移動してinclude("compiler/compiler.jl")を実行します。この方法を使えば、変更のたびにJuliaを再ビルドするよりも、通常ははるかに速く開発できます。
別の方法として、Revise.jlパッケージを使ってコンパイラーの変更を追跡できます。Juliaセッションの開始時にRevise.track(Core.Compiler)コマンドを実行してください。Revise documentationで説明されているように、変更したファイルを保存すると、コンパイラーへの変更が反映されます。
推論を始める際の便利な入口はtypeinf_codeです。convert(Int, UInt(1))に対して推論を実行する例を示します。
# Get the method
atypes = Tuple{Type{Int}, UInt}  # argument types
mths = methods(convert, atypes)  # worth checking that there is only one
m = first(mths)

# Create variables needed to call `typeinf_code`
interp = Core.Compiler.NativeInterpreter()
sparams = Core.svec()      # this particular method doesn't have type-parameters
run_optimizer = true       # run all inference optimizations
types = Tuple{typeof(convert), atypes.parameters...} # Tuple{typeof(convert), Type{Int}, UInt}
Core.Compiler.typeinf_code(interp, m, types, sparams, run_optimizer)デバッグ中にMethodInstanceが必要になった場合は、上記の変数の多くを使ってCore.Compiler.specialize_methodを呼び出すと確認できます。CodeInfoオブジェクトは、次のようにして取得できます。
# Returns the CodeInfo object for `convert(Int, ::UInt)`:
ci = (@code_typed convert(Int, UInt(1)))[1]
The inlining algorithm (inline_worthy)
インライン化に関する最も難しい処理の多くは、ssa_inlining_pass!で行われます。ただし、「なぜ自分の関数はインライン化されなかったのか」という疑問がある場合は、関数呼び出しをインライン化するかどうかを判断するinline_worthyに注目するとよいでしょう。
inline_worthyはコストモデルを実装しており、「低コスト」の関数をインライン化します。より具体的には、インライン化しない場合にissue a callする時間と比べて、予想実行時間が大きくない関数をインライン化します。このコストモデルは非常に単純で、多くの重要な要素を無視しています。たとえば、すべてのforループは1回だけ実行されるものとして解析され、if...else...endのコストにはすべての分岐のコストの合計が含まれます。また、コストモデルが実際の実行コストをどれほど正確に予測するかを検証するのに適した関数群が、現時点では用意されていないことにも留意してください。ただし、BaseBenchmarksからは、インライン化アルゴリズムの変更が成功したかどうかについて、多くの間接的な情報が得られます。
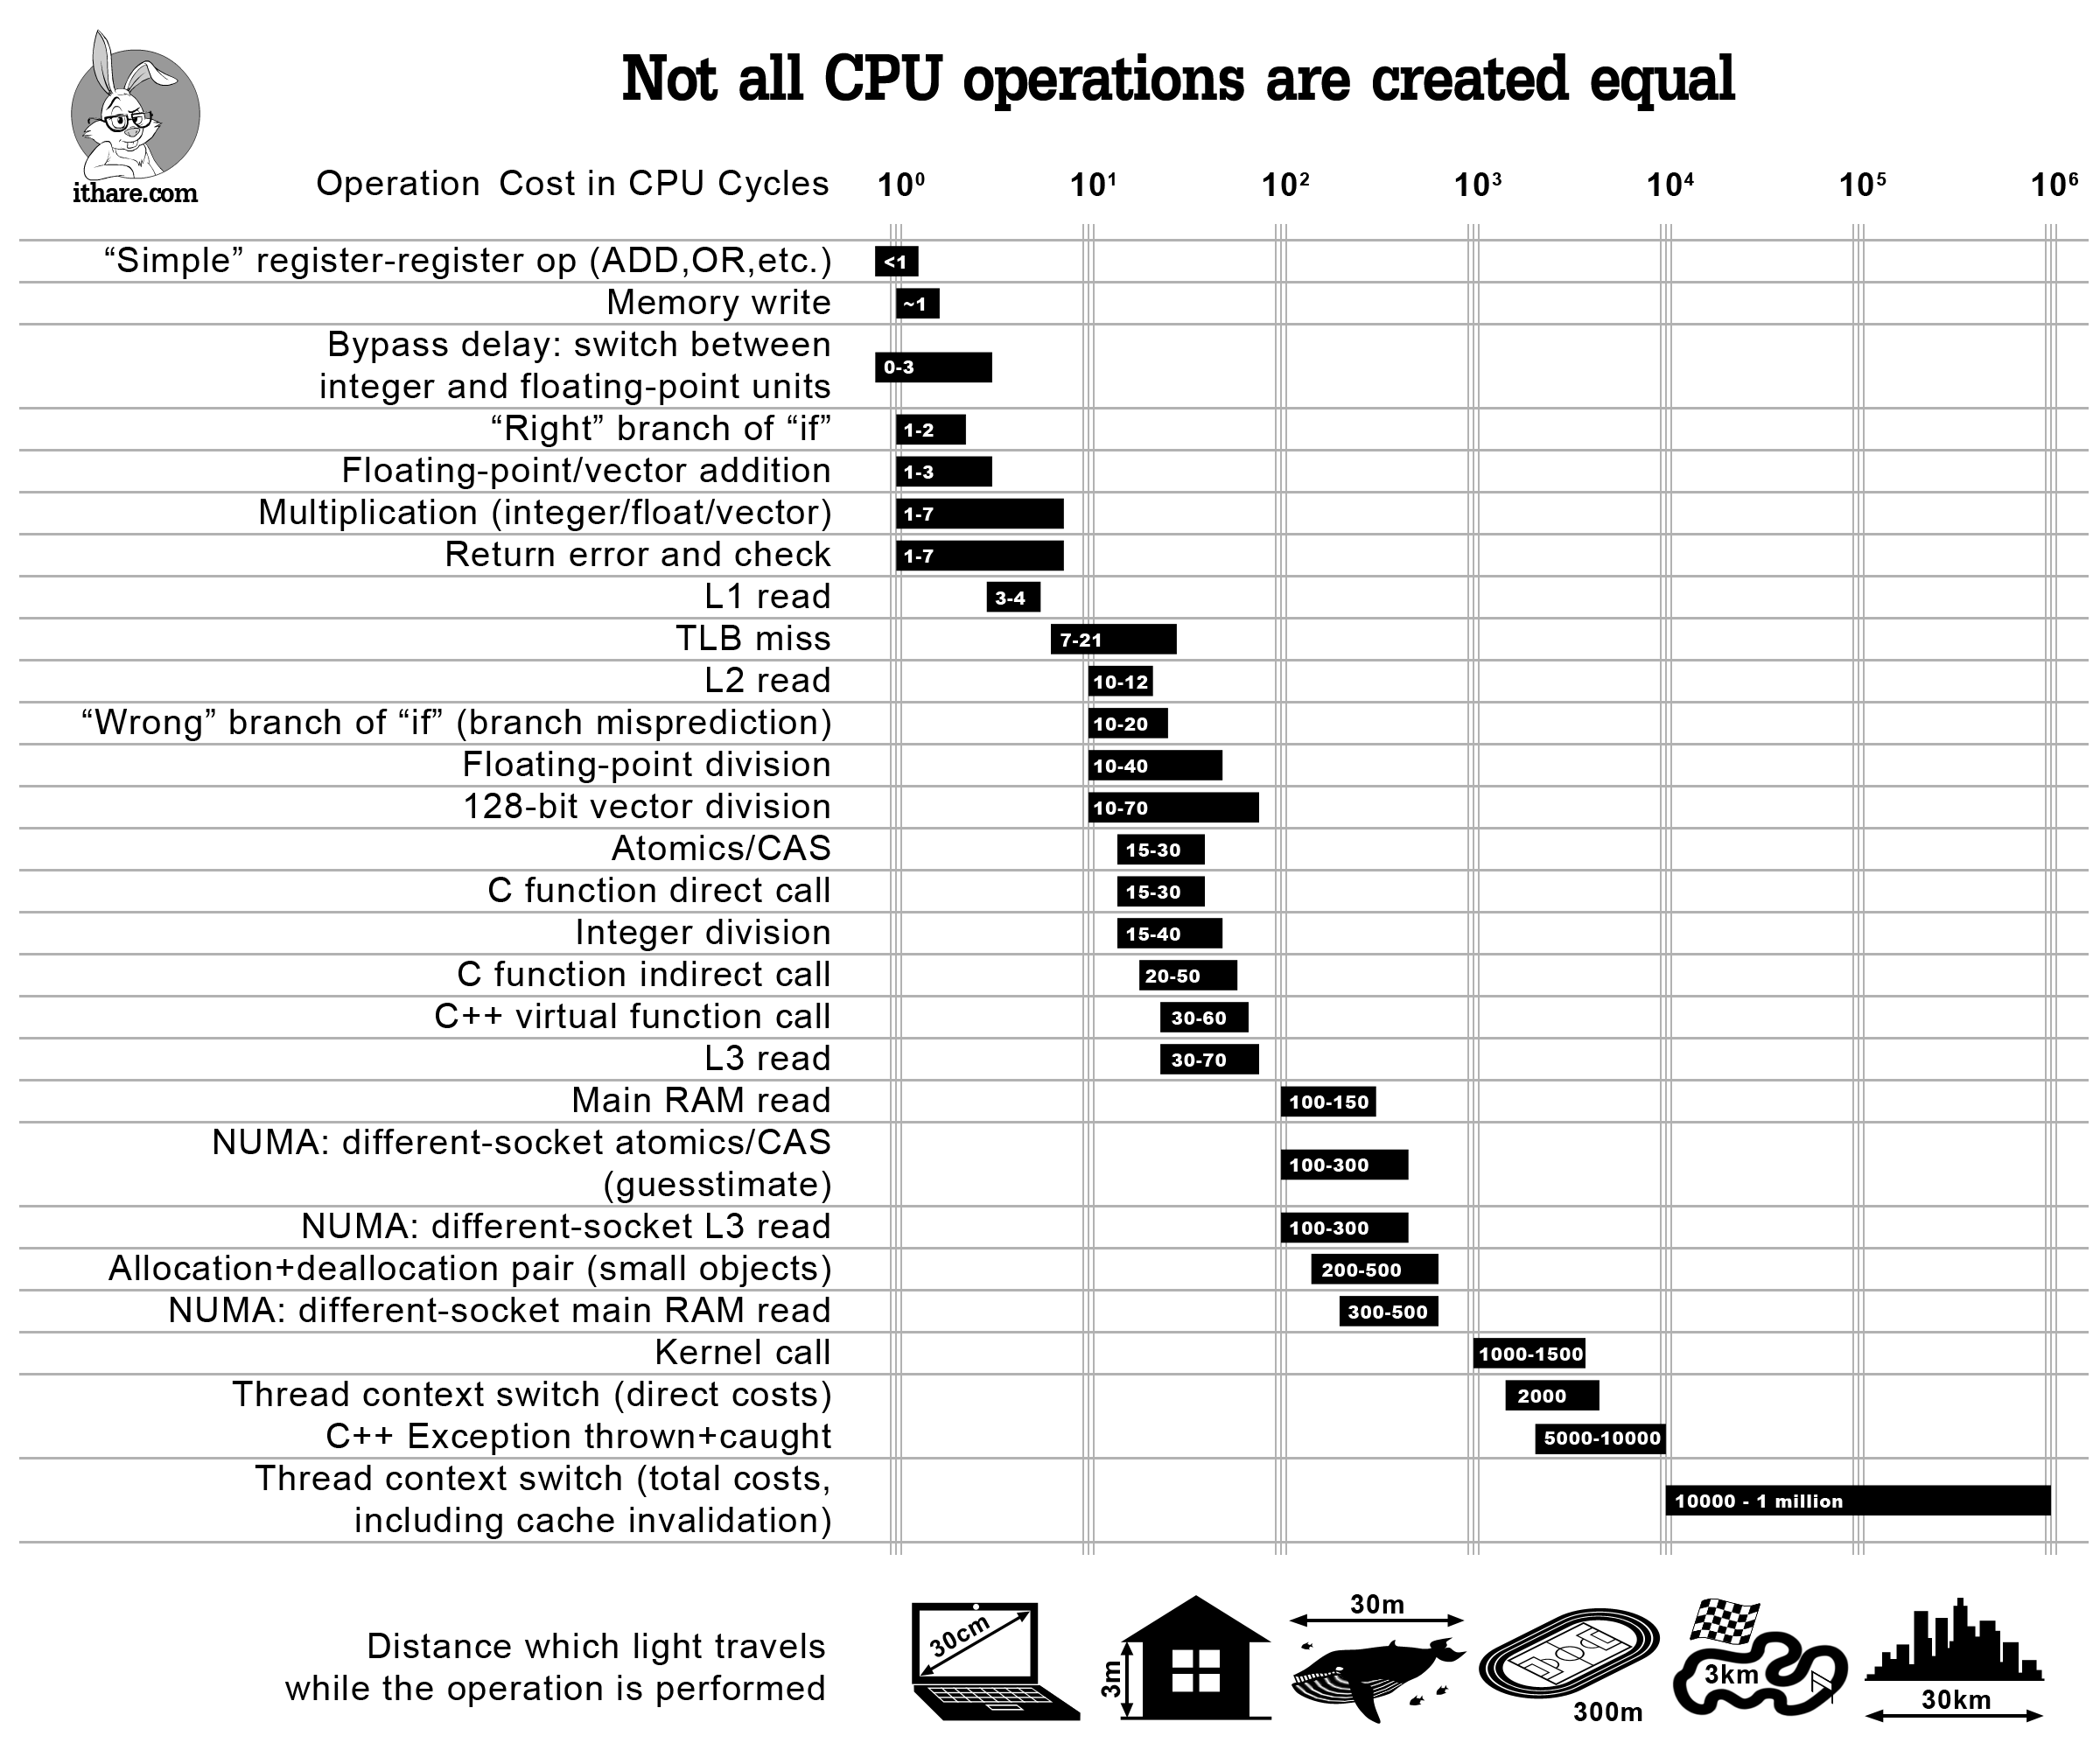
コストモデルの基盤となるのは、ルックアップテーブルです。このテーブルはadd_tfuncとその呼び出し元で実装されており、Juliaの各組み込み関数に推定コスト(CPUサイクル数)を割り当てます。これらのコストはstandard ranges for common architecturesに基づいています(詳しくはAgner Fog's analysisを参照してください)。
この低レベルのルックアップテーブルに加えて、いくつかの特別なケースも扱います。たとえば、:invoke式(入力と出力の型がすべて事前に推論されている呼び出し)には、固定コスト(現在は20サイクル)が割り当てられます。一方、組み込み関数以外の関数に対する:call式は、その呼び出しに動的ディスパッチが必要であることを示します。この場合、Params.inline_nonleaf_penaltyで設定されたコスト(現在は1000)を割り当てます。これは動的ディスパッチの実際のコストを第一原理から見積もったものではなく、動的ディスパッチが非常に高コストであることを示す単なるヒューリスティックです。
各文の総コストは、statement_costという関数で解析されます。各文に割り当てられたコストは、次のように表示できます。
julia> Base.print_statement_costs(stdout, map, (typeof(sqrt), Tuple{Int},)) # map(sqrt, (2,))
map(f, t::Tuple{Any}) @ Base tuple.jl:358
  0 1 ─ %1  = $(Expr(:boundscheck, true))::Bool
  0 │   %2  =   builtin Base.getfield(_3, 1, %1)::Int64
  1 │   %3  = intrinsic Base.sitofp(Float64, %2)::Float64
  0 │   %4  = intrinsic Base.lt_float(%3, 0.0)::Bool
  0 └──       goto #3 if not %4
  0 2 ─          invoke Base.Math.throw_complex_domainerror(:sqrt::Symbol, %3::Float64)::Union{}
  0 └──       unreachable
 20 3 ─ %8  = intrinsic Base.Math.sqrt_llvm(%3)::Float64
  0 └──       goto #4
  0 4 ─       goto #5
  0 5 ─ %11 =   builtin Core.tuple(%8)::Tuple{Float64}
  0 └──       return %11
左側の列に各行のコストが表示されます。このコストには、インライン化やその他の最適化による影響も含まれます。