JIT Design and Implementation
このドキュメントでは、codegen が完了し、最適化前の LLVM IR が生成された後の、Julia の JIT の設計と実装について説明します。JIT は、この IR を最適化してマシンコードにコンパイルし、現在のプロセスにリンクして、実行可能な状態にする役割を担います。
Introduction
JIT は、コンパイルリソースの管理、コンパイル済みコードの検索、新しいコードのコンパイルを担います。主に LLVM の On-Request-Compilation(ORCv2)技術を基盤としており、並行コンパイル、遅延コンパイル、別プロセスでのコードコンパイルなど、さまざまな便利な機能を利用できます。LLVM は LLJIT という基本的な JIT コンパイラを提供していますが、Julia は ORCv2 の API を多数直接利用して、独自の JIT コンパイラを構築しています。
Overview
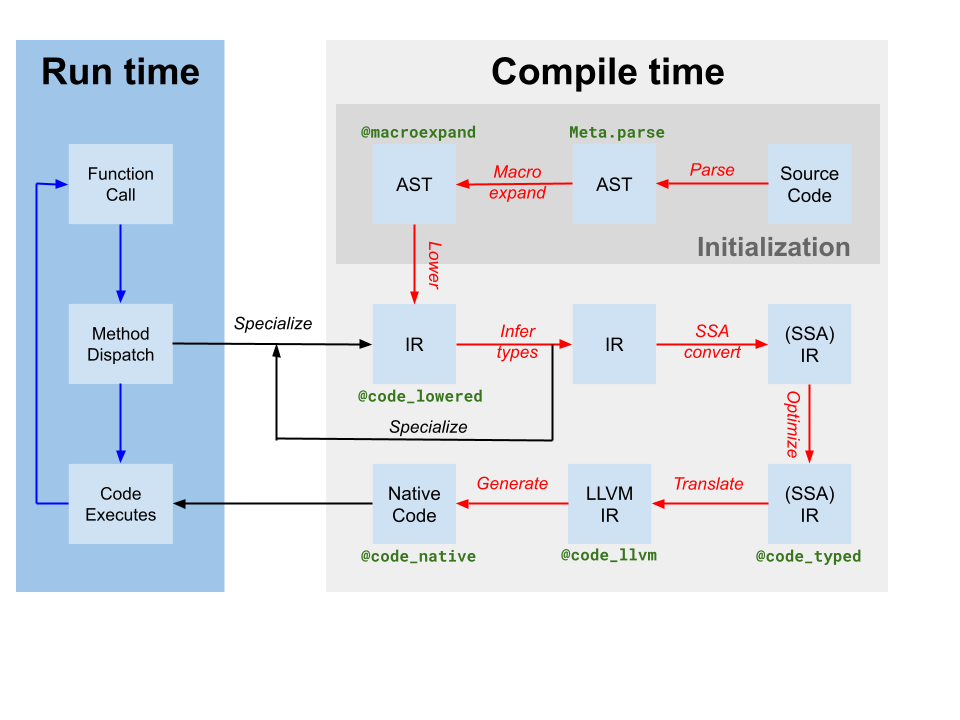
codegen は、型推論によって生成された元の Julia SSA IR から、1 つ以上の Julia 関数の IR を含む LLVM モジュールを生成します(上のコンパイラ図では「translate」と表示されています)。また、code-instance と LLVM 関数名の対応関係も生成します。ただし、Julia ベースのコンパイラによって Julia IR にいくつかの最適化が適用されているものの、codegen が生成する LLVM IR には、まだ多くの最適化の余地があります。そのため、JIT はまず、LLVM モジュールに対してターゲット非依存の最適化パイプライン[tdp]を実行します。次に、ターゲット固有の最適化とコード生成を含む、ターゲット依存の最適化パイプラインを実行し、オブジェクトファイルを出力します。最後に、生成されたオブジェクトファイルを現在のプロセスにリンクし、コードを実行可能な状態にします。これらの処理はすべて、src/jitlayers.cpp 内のコードによって制御されます。
現在は、リンカーの 1 つである RuntimeDyld の制約により、最適化・コンパイル・リンクのパイプラインに同時に入れるスレッドは 1 つだけです。ただし、JIT は並行した最適化とコンパイルをサポートするよう設計されており、すべてのプラットフォームで RuntimeDyld が完全に置き換えられれば、将来的にこのリンカーの制約は解消される見込みです。
Optimization Pipeline
最適化パイプラインは LLVM の新しいパスマネージャーを基盤としていますが、Julia の要件に合わせてカスタマイズされています。パイプラインは src/pipeline.cpp で定義されており、以下に示す複数の段階を経て処理が進みます。
初期の簡略化
- これらのパスは主に、IR を簡略化し、パターンを正規化して、後続のパスがそのパターンを見つけやすくするために使われます。また、分岐予測ヒントや注釈などのさまざまな intrinsic 呼び出しは、他のメタデータや IR の機能に変換されます。ここで重要な役割を果たすのは、
SimplifyCFG(制御フローグラフの簡略化)、DCE(デッドコード除去)、SROA(集成体のスカラー置換)などです。
- これらのパスは主に、IR を簡略化し、パターンを正規化して、後続のパスがそのパターンを見つけやすくするために使われます。また、分岐予測ヒントや注釈などのさまざまな intrinsic 呼び出しは、他のメタデータや IR の機能に変換されます。ここで重要な役割を果たすのは、
初期の最適化
- これらのパスは一般に低コストで、主に IR 内の命令数を減らし、得られた情報を他の命令へ伝播させることを目的としています。たとえば、
EarlyCSEは共通部分式除去に使われ、InstCombineとInstSimplifyは、演算のコストを下げるための小規模なピープホール最適化をいくつか実行します。
- これらのパスは一般に低コストで、主に IR 内の命令数を減らし、得られた情報を他の命令へ伝播させることを目的としています。たとえば、
ループ最適化
- これらのパスはループを正規化し、簡略化します。ループはホットコードであることが多いため、ループ最適化は性能にとって非常に重要です。主なパスには
LoopRotate、LICM、LoopFullUnrollがあります。また、IRCEパスによって特定の境界を超えないことを証明できるため、ここでは境界チェックの除去も行われます。
- これらのパスはループを正規化し、簡略化します。ループはホットコードであることが多いため、ループ最適化は性能にとって非常に重要です。主なパスには
スカラー最適化
ベクトル化
- Automatic vectorization は、CPU 負荷の高いコードに対して非常に強力な変換です。簡単に言うと、ベクトル化によって single instruction on multiple data(SIMD)を実行できるようになります。たとえば、8 回の加算を同時に行えます。ただし、コードがベクトル化可能であり、かつベクトル化する価値があると証明するのは困難です。そのため、ベクトル化が有効になるよう IR を整えるうえで、先行する最適化パスが大きな役割を果たします。
intrinsic の低レベル化
- Julia は、オブジェクトの割り当て、ガベージコレクション、例外処理などのために、独自の intrinsic をいくつか挿入します。これらの intrinsic は、もともと最適化の機会を見つけやすくするために導入されましたが、IR をマシンコードとして出力できるよう、現在は LLVM IR に低レベル化されます。
クリーンアップ
- これらのパスは最後の最適化であり、積和演算の伝播や除算・剰余の簡略化など、小規模な最適化を行います。また、半精度浮動小数点数をサポートしないターゲットでは、ここで半精度命令を単精度命令に低レベル化します。さらに、サニタイザーをサポートするパスも追加されます。
Target-Dependent Optimization and Code Generation
LLVM は、特定のプラットフォームの TargetMachine 内にある同一のパイプラインで、ターゲット依存の最適化とマシンコード生成を行います。これらのパスには、命令選択、命令スケジューリング、レジスタ割り当て、マシンコード出力が含まれます。この処理の概要は LLVM のドキュメントに詳しく説明されています。パイプラインや各パスの詳細を調べるには、LLVM のソースコードが最適です。
Linking
現在、Julia は旧来の RuntimeDyld リンカーから、新しい JITLink リンカーへの移行を進めています。JITLink には、並行リンクや再入可能なリンクなど、RuntimeDyld にはない機能がいくつかあります。一方で、現時点ではプロファイリング連携のサポートが十分ではなく、RuntimeDyld がサポートするすべてのプラットフォームにも対応していません。将来的には、JITLink が RuntimeDyld を完全に置き換える見込みです。JITLink の詳細については、LLVM のドキュメントを参照してください。
Execution
コードが現在のプロセスにリンクされると、実行可能になります。このことは、invoke、specsigflags、specptr の各フィールドを適切に更新することで、生成元の codeinst に通知されます。codeinst では、これらのフィールドの組み合わせが、その時点で存在するすべての状態において呼び出し可能である限り、invoke、specsigflags、specptr の各フィールドを段階的に更新できます。これにより、既存の codeinst を無効化せずに JIT がこれらのフィールドを更新できるため、将来的な並行 JIT の実現が可能になります。具体的には、次の状態が有効です。
invokeが NULL、specsigflagsが 0b00、specptrが NULL- これは codeinst の初期状態であり、まだコンパイルされていないことを示します。
invokeが NULL 以外、specsigflagsが 0b00、specptrが NULL- これは、codeinst が特殊化なしでコンパイルされ、codeinst を直接呼び出すべきことを示します。この場合、
invokeはspecsigflagsフィールドもspecptrフィールドも読み取りません。そのため、invokeポインターを無効化せずに、これらのフィールドを変更できます。
- これは、codeinst が特殊化なしでコンパイルされ、codeinst を直接呼び出すべきことを示します。この場合、
invokeが NULL 以外、specsigflagsが 0b10、specptrが NULL 以外- これは codeinst がコンパイル済みであるものの、codegen によって特殊化された関数シグネチャは不要と判断されたことを示します。
invokeが NULL 以外、specsigflagsが 0b11、specptrが NULL 以外- これは codeinst がコンパイル済みであり、codegen によって特殊化された関数シグネチャが必要と判断されたことを示します。
specptrフィールドには、特殊化された関数シグネチャへのポインターが格納されます。invokeポインターは、specsigflagsフィールドとspecptrフィールドの両方を読み取ることができます。
- これは codeinst がコンパイル済みであり、codegen によって特殊化された関数シグネチャが必要と判断されたことを示します。
さらに、更新処理中にはさまざまな中間状態が発生します。こうした状況に対応するため、これらの codeinst フィールドを扱う際は、次の書き込み・読み取りパターンを使用してください。
invoke、specsigflags、specptrを書き込む場合:- specptr の古い値が NULL であることを前提に、アトミックな compare-exchange 操作を行います。この compare-exchange 操作には、書き込みに含まれる残りのメモリ操作の順序を保証するため、少なくとも acquire-release のメモリ順序を指定してください。
specptrが NULL 以外の場合は、書き込みを中止し、specsigflagsのビット 0b10 が書き込まれるまで待ちます。その後、必要であれば手順 1 から再開します。specsigflagsの新しい下位ビットを最終値に設定します。これは relaxed 書き込みでもかまいません。- 新しい
invokeポインターを最終値に設定します。invokeの読み取りと同期するため、少なくとも release のメモリ順序が必要です。 specsigflagsの 2 番目のビットを 1 に設定します。specsigflagsの読み取りと同期するため、少なくとも release のメモリ順序が必要です。この手順で書き込みが完了し、すべてのフィールドが設定されたことを他のすべてのスレッドに通知します。
invoke、specsigflags、specptrのすべてを読み取る場合:specptrフィールドを、任意のメモリ順序で読み取ります。invokeフィールドを、少なくとも acquire のメモリ順序で読み取ります。このロードをinitial_invokeと呼びます。initial_invokeが NULL の場合、codeinst はまだ実行可能ではありません。invokeは NULL、specsigflagsは 0b00、specptrは NULL として扱えます。specptrが NULL の場合、initial_invokeポインターは、正しい実行を保証するためにspecptrに依存していてはなりません。したがって、invokeは NULL 以外であり、specsigflagsは 0b00、specptrは NULL として扱えます。specptrが NULL 以外の場合、initial_invokeは、specptrを使用する最終的なinvokeフィールドではない可能性があります。これは、specptrは書き込まれているものの、invokeはまだ書き込まれていない場合に起こり得ます。そのため、specsigflagsの 2 番目のビットが、少なくとも acquire のメモリ順序で 1 に設定されるまでスピン待機します。invokeフィールドを、任意のメモリ順序で再読み込みします。このロードをfinal_invokeと呼びます。specsigflagsフィールドを、任意のメモリ順序で読み取ります。invokeはfinal_invoke、specsigflagsは手順 7 で読み取った値、specptrは手順 3 で読み取った値です。
specptrを、異なるものの同等な関数ポインターに更新する場合:- 新しい関数ポインターを
specptrに release ストアします。古い関数ポインターは引き続き有効である必要があり、新しい関数ポインターも有効でなければならないため、ここで競合が起きても問題がないようにしてください。specptrに書き込まれたポインターは、後で上書きされるかどうかにかかわらず、常に呼び出し可能でなければなりません。
- 新しい関数ポインターを
これらのフィールドを正しく読み取る処理は、jl_read_codeinst_invoke に実装されています。
書き込み、読み取り、更新の手順は複雑ですが、既存の codeinst や既存の invoke ポインターを無効化せずに、JIT が codeinst を更新できるようにします。これにより、将来的には JIT が関数をより高い最適化レベルで再最適化できる可能性があり、関数の並行コンパイルもサポートできるようになります。
- tdpこれは完全にターゲット非依存のパイプラインではありません。ベクトル化などの変換は、ベクトルレジスタ幅やコストモデルといったターゲット情報に依存するためです。また、codegen 自体もターゲット依存の前提をいくつか置いており、最適化パイプラインはその情報を活用します。